📥 Скачать Oruza для Windows
Скачать установщик (.exe)Размер: ~305МБ
💡 Python не требуется! Программа работает как готовое приложение.
🛠️ Установка программы
Скачайте установщик
Нажмите кнопку выше для загрузки файла Oruza_v2_Setup.exe.
Запустите установщик
Дважды кликните по скачанному файлу. Если появится предупреждение от Windows SmartScreen, нажмите "Подробнее" → "Выполнить в любом случае" (это стандартное предупреждение для новых приложений).
Следуйте мастеру установки
Выберите папку для установки (рекомендуется оставить по умолчанию) и нажмите "Установить". Установка займёт несколько секунд.
Запустите Oruza
После установки программа автоматически запустится, или вы можете найти её в меню "Пуск" → папка "Oruza" → ярлык "Oruza".
При первом использовании программы потребуется интернет для автоматической загрузки моделей распознавания речи (~40-470 МБ в зависимости от выбранной модели) и пунктуации (~1.6 ГБ). Далее программа работает полностью оффлайн.
🖼️ Интерфейс программы
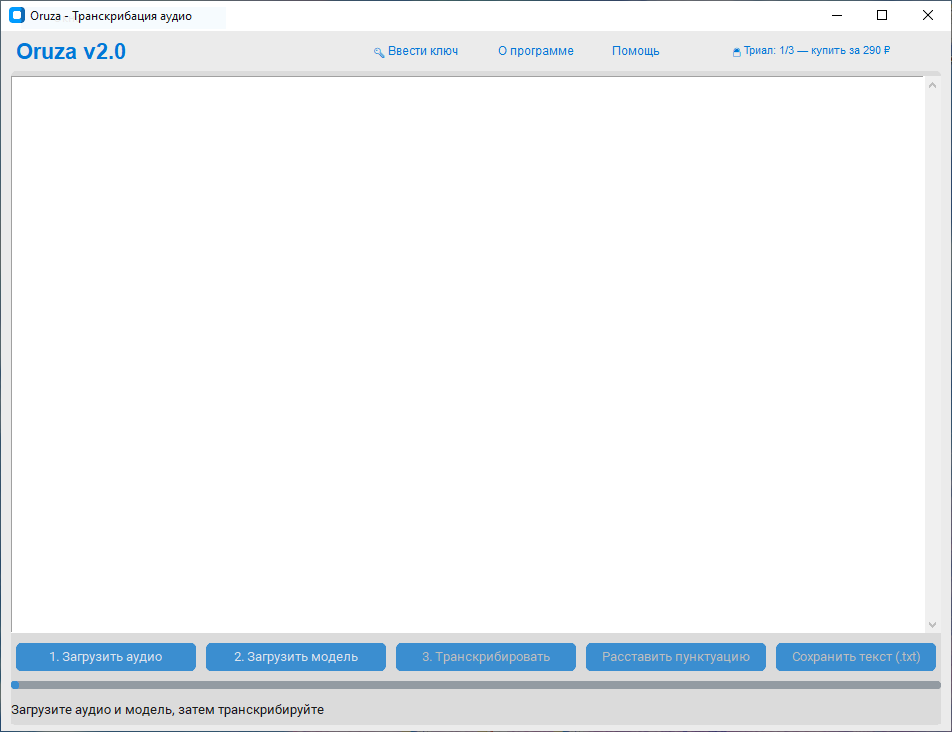
Главное окно программы с панелью управления
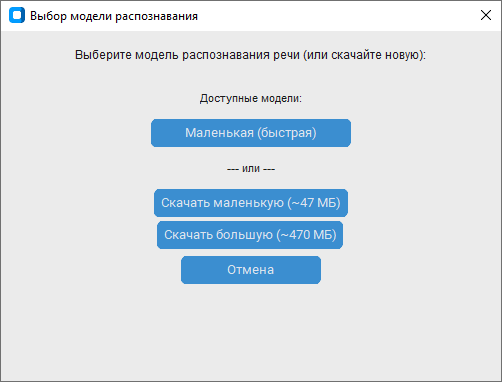
Окно выбора или скачивания модели распознавания
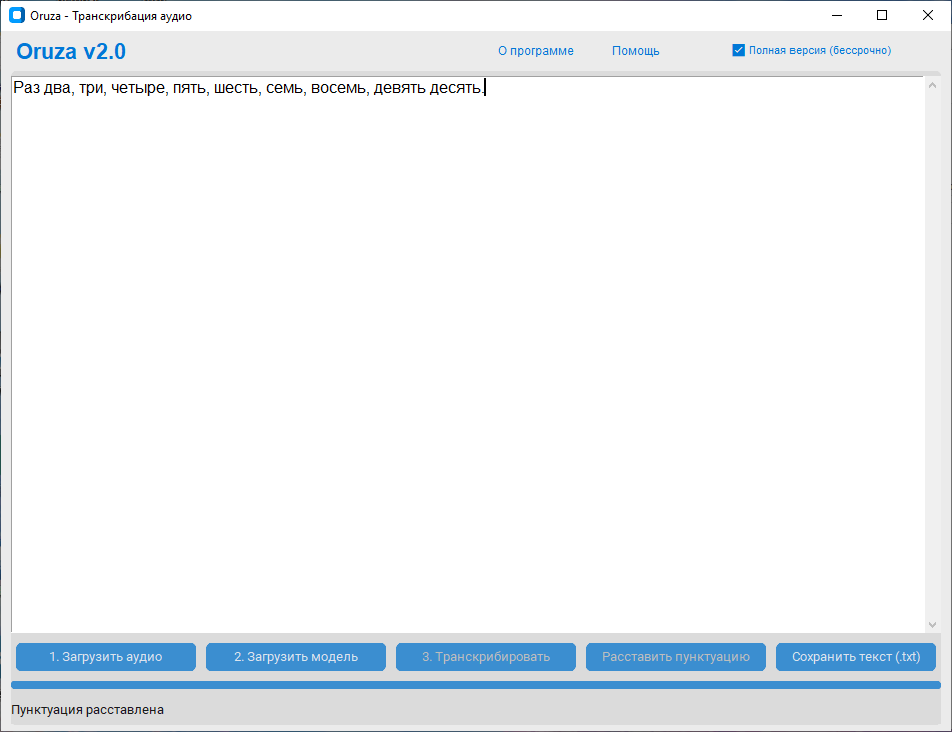
Окно с текстом
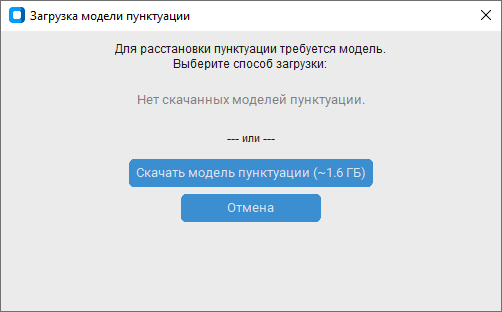
Окно выбора модели пунктуации
📝 Пошаговое использование
1. Загрузите аудиофайл
Нажмите кнопку "1. Загрузить аудио" и выберите файл (поддерживаются MP3, WAV, FLAC, OGG, M4A, AAC, WMA). Программа автоматически сконвертирует его в нужный формат.
2. Загрузите модель распознавания
Нажмите "2. Загрузить модель" и выберите:
- Маленькая модель (~40 МБ) — быстрая, подходит для большинства задач
- Большая модель (~470 МБ) — более точная, но медленнее
Модель скачается автоматически при первом выборе.
3. Транскрибируйте
Нажмите "3. Транскрибировать". Начнётся распознавание речи. Прогресс отображается на шкале. Время обработки зависит от длины файла и мощности вашего компьютера.
4. Расставьте пунктуацию (опционально)
После транскрибации нажмите "Расставить пунктуацию". При первом использовании скачается модель пунктуации (~1.6 ГБ). Это улучшит читаемость текста.
5. Сохраните результат
Нажмите "Сохранить текст (.txt)" и выберите место для сохранения файла.
🔑 Пробная версия и активация
При первом запуске вам доступно 3 бесплатные транскрибации для тестирования программы.
Как активировать полную версию:
- После использования пробных транскрибаций нажмите кнопку "🔑 Ввести ключ" в верхней панели
- Приобретите лицензию за 290 ₽ через Telegram: @igorecio
- Получите лицензионный ключ формата
- Введите ключ в поле активации и нажмите "Активировать"
- Неограниченное количество транскрибаций
- Бессрочная лицензия (платите один раз)
- Все будущие обновления бесплатно
- Доступ ко всем функциям программы
💡 Рекомендации
- Используйте чёткие аудиозаписи без фонового шума
- Оптимальный формат — WAV 16kHz Mono (программа конвертирует автоматически)
- Говорящий должен произносить слова разборчиво
- Минимизируйте посторонние звуки и музыку
- Антивирус: При первом запуске антивирус может выдать предупреждение (ложное срабатывание для Python-приложений). Добавьте программу в исключения или временно отключите защиту.
- Производительность: Программа работает на слабых ПК, но время транскрибации зависит от длины файла и мощности процессора.
- Место на диске: Убедитесь, что на диске C: есть минимум 2-3 ГБ свободного места для моделей.
- Интернет: Требуется только при первом запуске для скачивания моделей. Далее программа работает полностью оффлайн.
🔧 Решение проблем
Программа не запускается
- Убедитесь, что у вас Windows 7 или новее (64-bit)
- Попробуйте запустить от имени администратора (правый клик → "Запуск от имени администратора")
- Проверьте, не блокирует ли антивирус программу
Ошибка при загрузке модели
- Проверьте подключение к интернету
- Отключите VPN или прокси
- Попробуйте скачать модель ещё раз
- Проверьте наличие свободного места на диске
Плохое качество распознавания
- Используйте большую модель вместо маленькой
- Убедитесь, что в аудио хороший звук без шумов
- Проверьте, что говорящий использует русский язык
Программа работает медленно
- Закройте другие программы для освобождения ресурсов
- Используйте маленькую модель для ускорения
- Помните: время обработки зависит от длины файла — это нормально
Поддержка
Если у вас возникли вопросы или проблемы, напишите нам:
- 📧 Email: selentsio@yandex.ru
- 💬 Telegram: @igorecio
- 🌐 Сайт: oruza.ru
Мы всегда на связи.